

写在前面
最近不是要买商品房当宿舍吗,这个是之前给liv研究生租房时的图
逆向入门指北
这个题主要是让你看pdf的,甚至没必要查壳(当然每个题都要查)
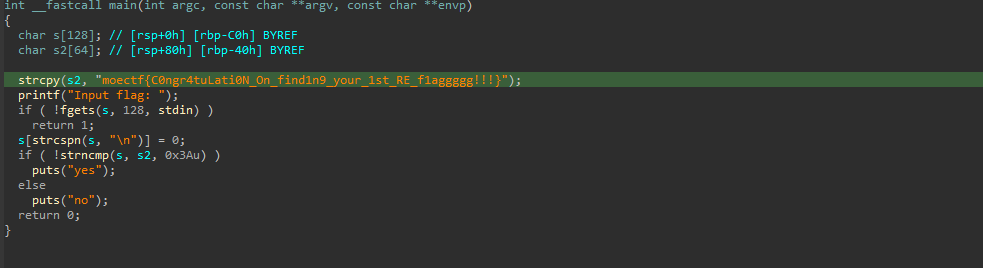
拖进ida就能看见答案也没啥好说的
bbxor
查壳没啥问题,进ida看,
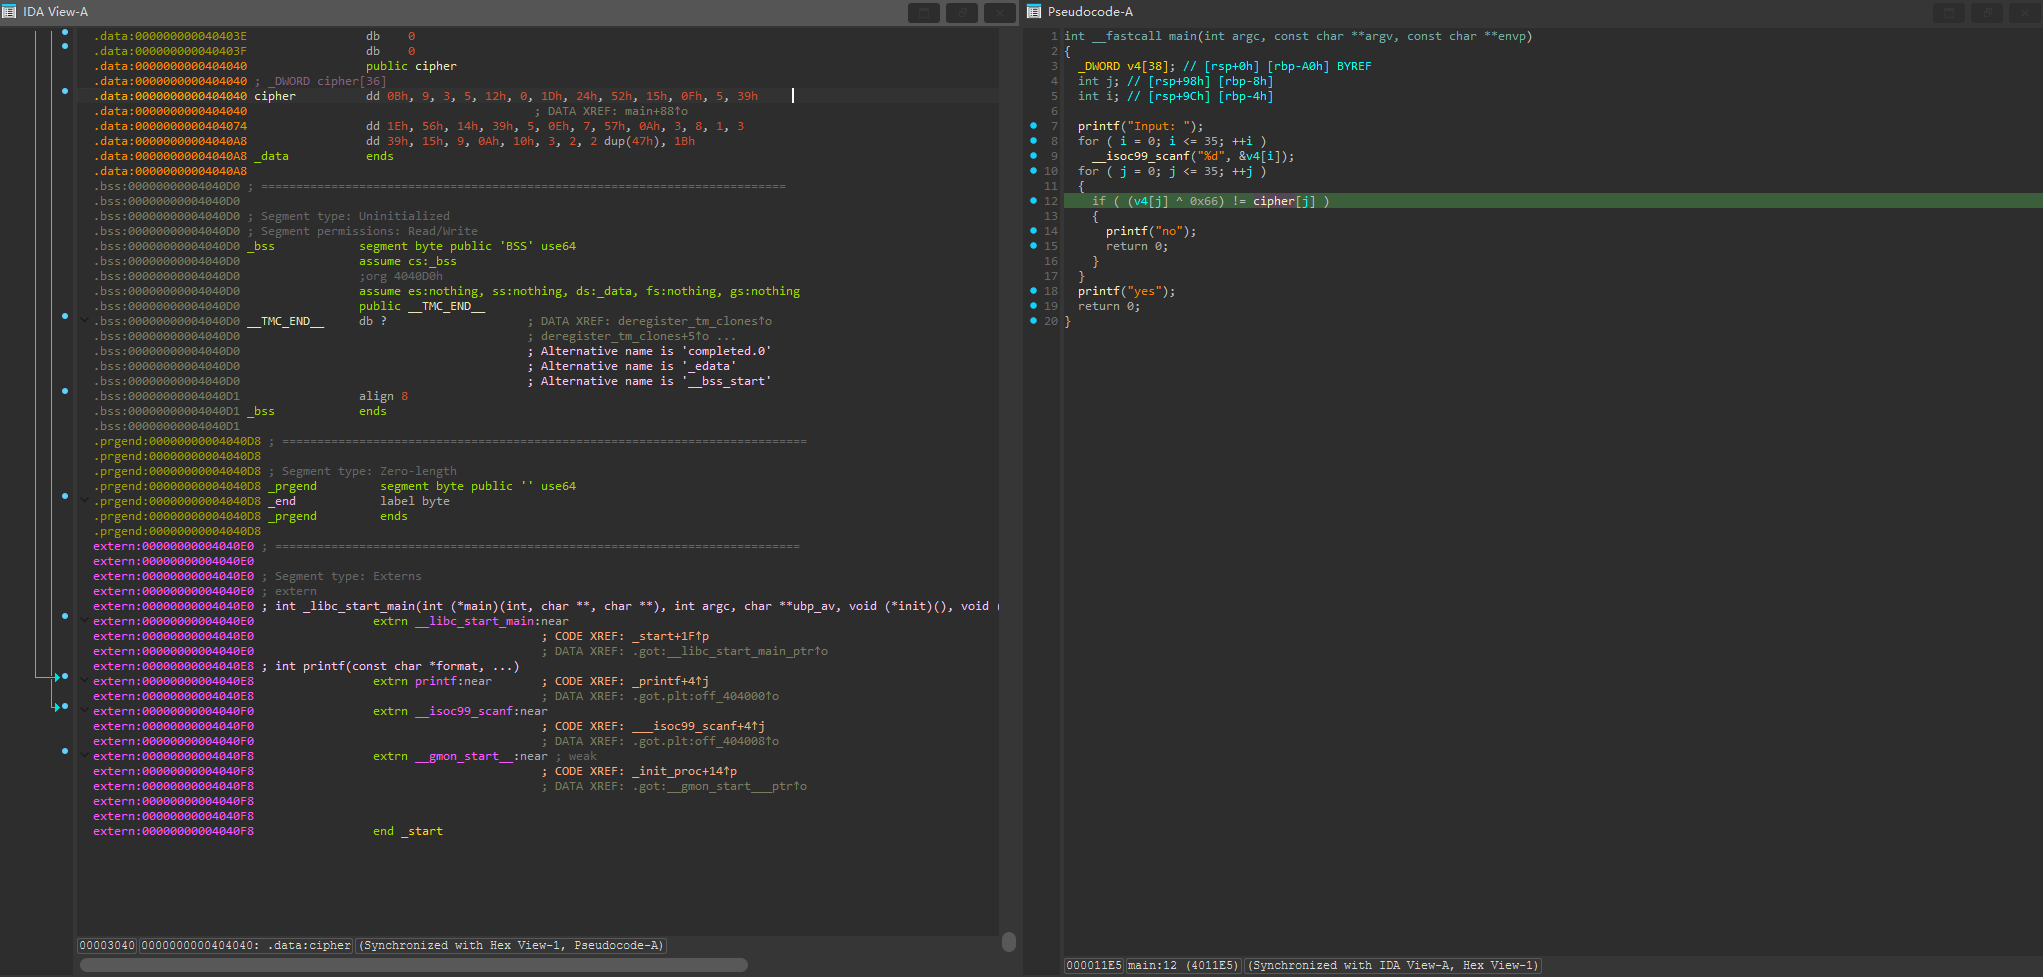
然后发现只做了一步很简单的XOR,由对称性,XOR回去就行了。
让我们说中文
查壳没什么问题,拖进IDA
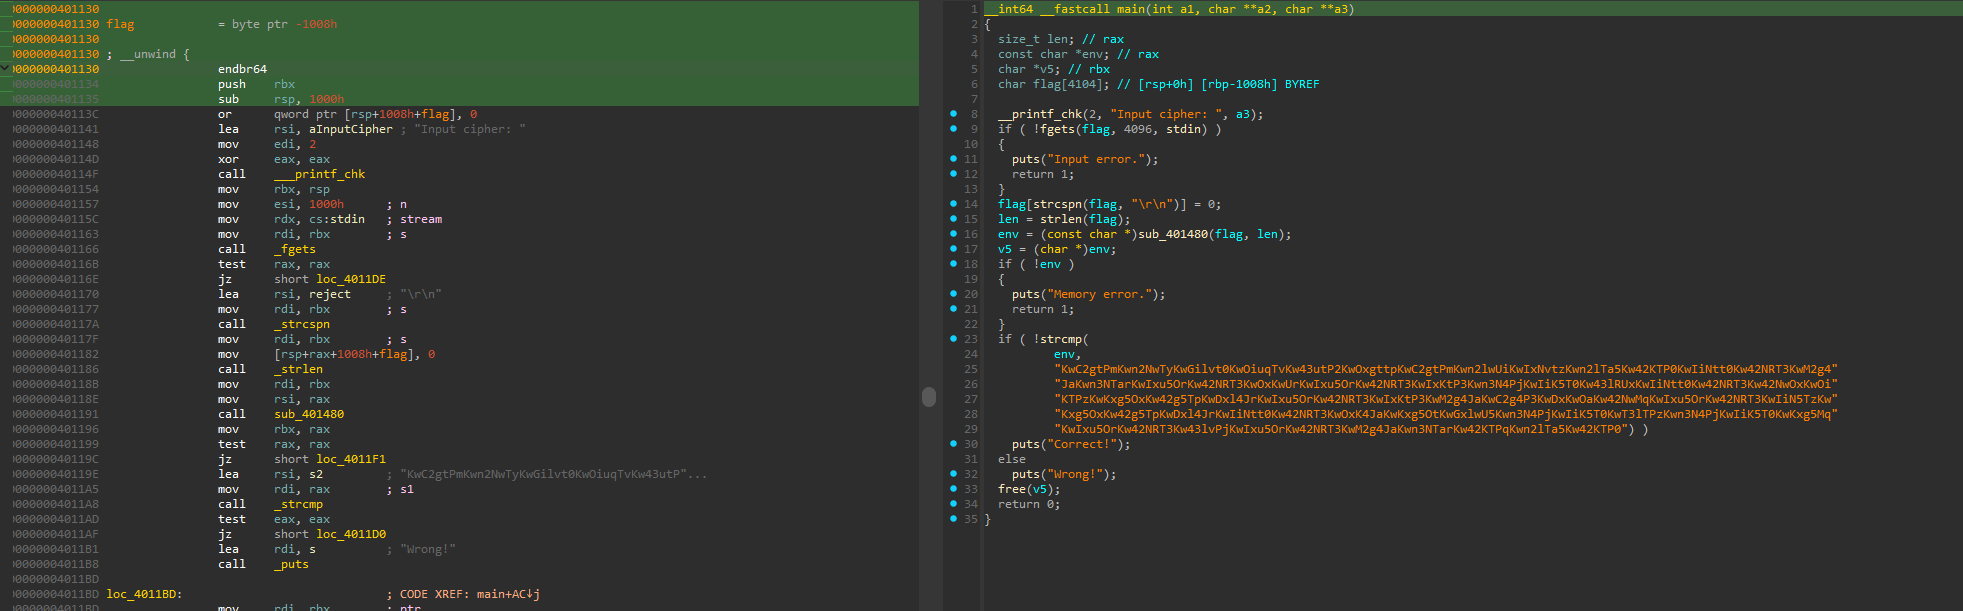
根据
env = (const char *)sub_401480(flag, len);点进sub_401480
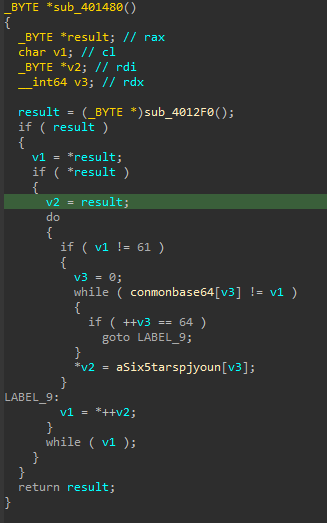
先进sub_4012F0
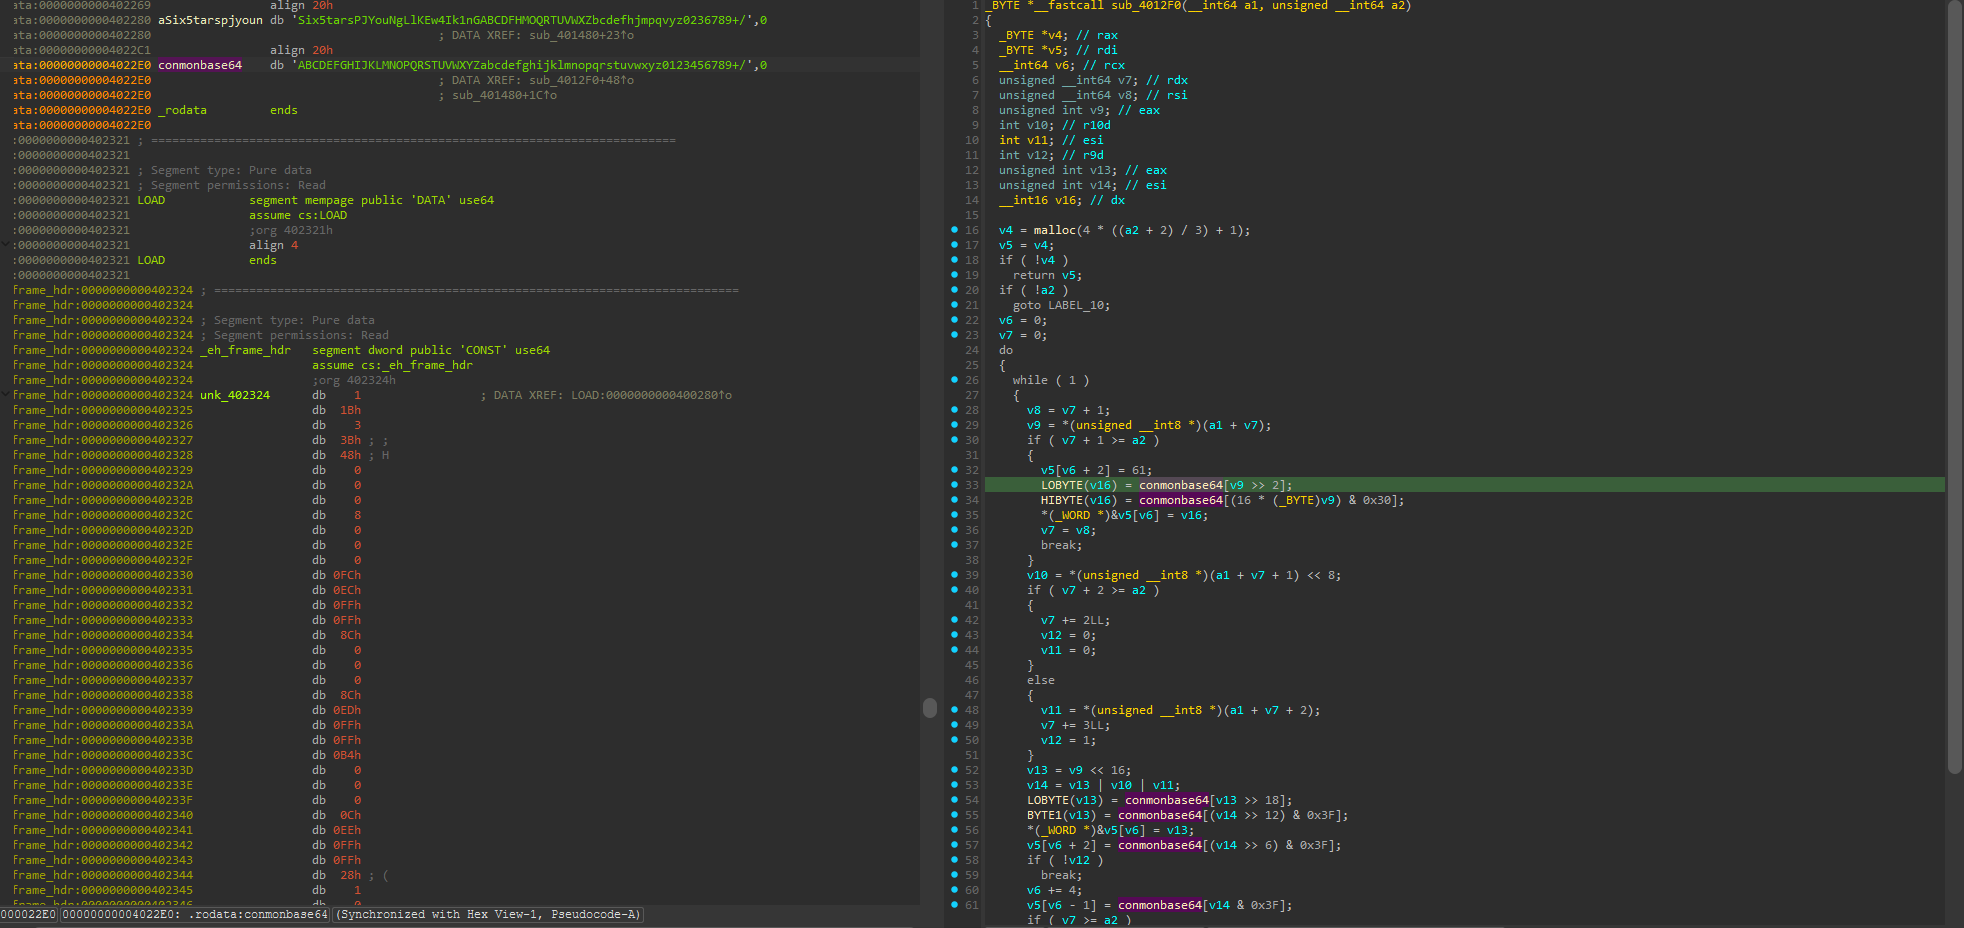
再加上
v4 = malloc(4 * ((a2 + 2) / 3) + 1);
4 \* ((len + 2) / 3) + 1是 Base64 编码后的最大长度公式。- 每 3 个字节编码成 4 个字符。
+1用于存放字符串结束符\0。
基本可以确定是base64相关
再看回来
result = (_BYTE *)sub_4012F0(); // 在这里进行base64编码,对flag以及len操作 if ( result ) { v1 = *result; if ( *result ) { v2 = result; do { if ( v1 != 61 ) { v3 = 0; while ( conmonbase64[v3] != v1 ) { if ( ++v3 == 64 ) goto LABEL_9; } *v2 = aSix5tarspjyoun[v3];//conmonbase64[v3] = v1时执行,取aSix5tarspjyoun的[v3]来替换 }LABEL_9: v1 = *++v2; } while ( v1 ); } } return result;}如果对于result的每一个值,不等于61(=)的话,将其用aSix5tarspjyoun[v3]替换(++v3 == 64是先++再比较64,即64 个字符的自定义表找不到就跳转LABEL_9)
核心逻辑就是:先base64,然后不等于61的用自定义字典同序号字符替换。
逆向过来就是把两个字典的位置换一下就好了,然后赛博厨子”from base64”
手写汇编
; x86-64, Intel syntax; rdi points to output buffer
start: lea rdi, [buf]
lea rsi, [byte_404000];先读[byte_404000] mov ecx, 25
loc_401000: mov al, byte ptr [rsi] mov byte ptr [rdi], al inc rsi ;(rsi += 1) inc rdi ;(rdi += 1) loop loc_401000 ; (ecx -= 1; 若 ecx != 0 则跳回 loc_401000)(循环结束后 rsi = byte_404000+25,rdi = buf+25)
mov eax, 0x2a add eax, 0x16 cmp eax, 0x40 jne loc_401080;(相等 → jne 不跳转,继续往下走)
mov ebx, 0x10 shl ebx, 2 cmp eax, ebx jne loc_401080 ;你又不跳
mov ecx, 0x39 sub ecx, 0x20 cmp ecx, 0x18 jg loc_401050;跳
jmp loc_401080
loc_401050: lea rsi, [byte_404020];再读第二段数据 [byte_404020] mov ecx, 15
loc_401060: mov al, byte ptr [rsi];al说明是一个字节 xor al, 0x42;简单的一个XOR mov byte ptr [rdi], al inc rsi inc rdi loop loc_401060
jmp loc_4010b0;循环完跳转
loc_401080: lea rsi, [byte_404030] mov ecx, 9
loc_401090: mov al, byte ptr [rsi] mov byte ptr [rdi], al inc rsi inc rdi loop loc_401090
loc_4010b0: mov byte ptr [rdi], 0 ret
byte_404000: db 0x6d, 0x6f, 0x65, 0x63, 0x74, 0x66, 0x7b db 0x41, 0x73, 0x73, 0x65, 0x6d, 0x62, 0x31, 0x79 db 0x5f, 0x4c, 0x34, 0x6e, 0x67, 0x75, 0x61, 0x67, 0x65, 0x5f
byte_404020: db 0x73, 0x11, 0x1d, 0x21, 0x2d db 0x72, 0x2d, 0x72, 0x0d, 0x2d db 0x2d, 0x2e, 0x63, 0x63, 0x3f
byte_404030: db 0x63, 0x6f, 0x72, 0x72, 0x65, 0x63, 0x74, 0x21, 0x7d
buf: db 64 dup(0)逻辑在注释里标的很清楚了,详细知识可以看huoya爷或者国资社畜的资料。
byte_404000不用动,byte_404020要XOR0x42再加上即可。
请你喝茶
week1怎么没一个要脱壳的
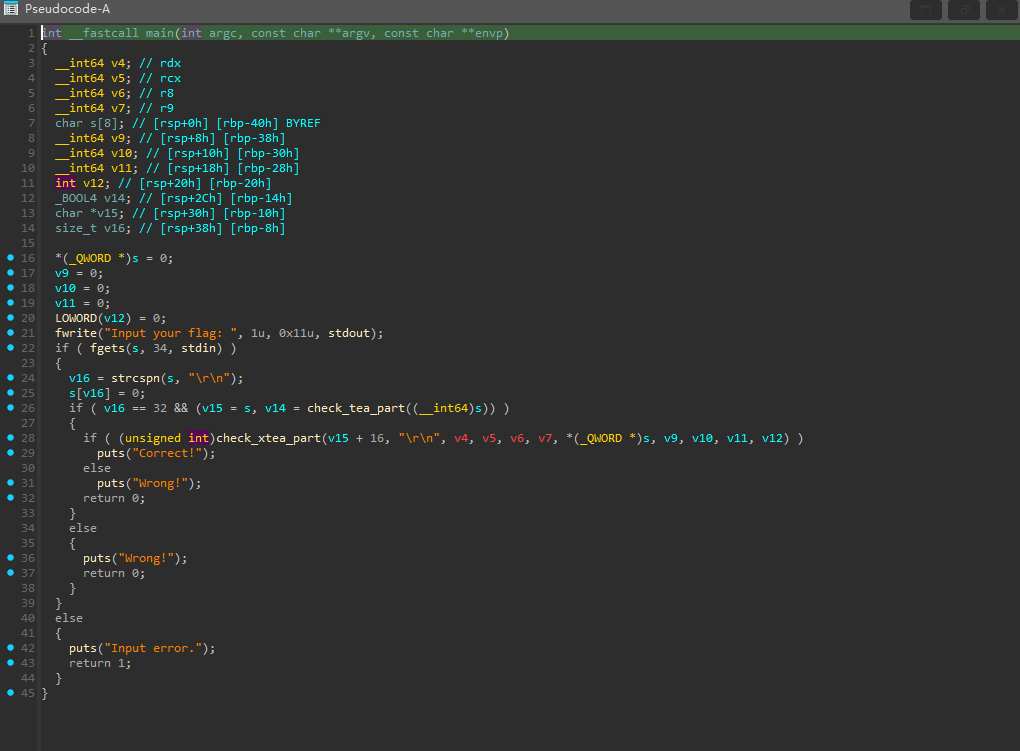
开IDA,发现xteapart是v15+16开始,长度v16为32,那么一半tea一半xtea.
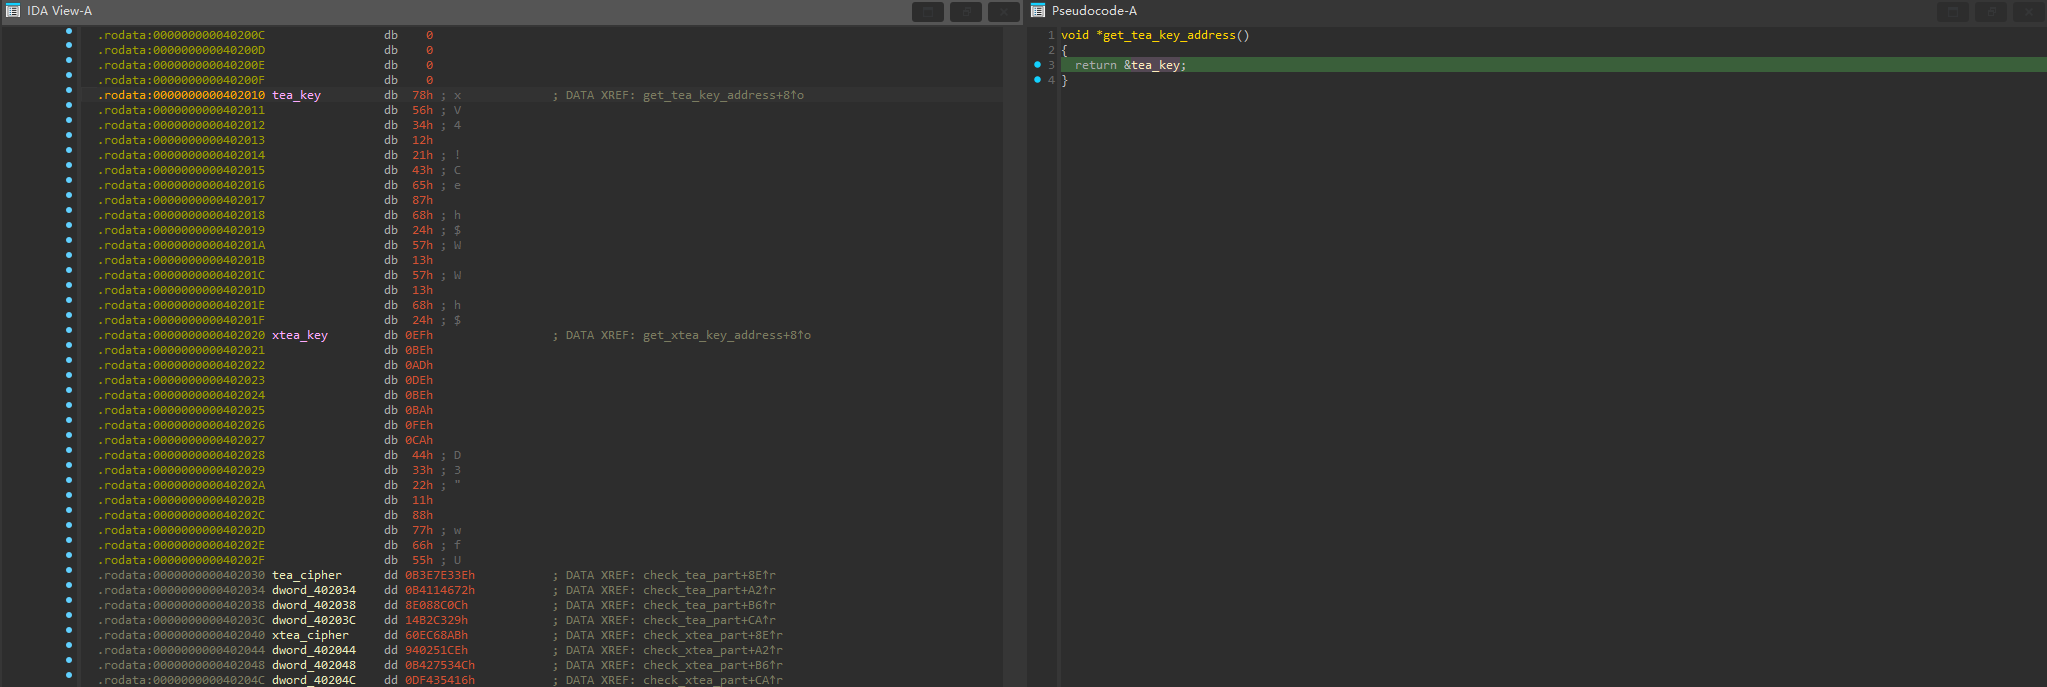
跟着代码走,追到这里,发现全部参数都齐了,那就可以开始写脚本了。
bing上一搜就能看到TEA/XTEA的加密以及解密原理了
简明扼要,由于加密的每一轮操作在已知密钥下都是可逆的,只需要将其逆过来便可以完成解密
v6 = *a1; v5 = a1[1]; delta1 = 0; for ( i = 0; i <= 0x1F; ++i ) { delta1 -= 1640531527; v6 += (v5 + delta1) ^ (16 * v5 + *key) ^ ((v5 >> 5) + key[1]); v5 += (v6 + delta1) ^ (16 * v6 + key[2]) ^ ((v6 >> 5) + key[3]); } *a1 = v6; a1[1] = v5; return v5;}解密便是把循环的这三条顺序反过来,+=改成-=, v5v6位置一换,就可以了。XTEA同理
k[(sum >> 11) & 3] 只由 sum 这个数决定。此处解密属于撤销行为,所以不用动
再把tea_cipher以及xtea_cipher带入运算即可。
注:标准 XTEA 为 64 轮;模板中 xtea_decrypt 的循环次数与 delta 初值须与题目反编译的 xtea_encrypt 轮数一致(本模板为 32 轮),否则会解不出来。
什么叫他让我填空就行了
#include <stdio.h>/** * @brief 这是一个简短的 TEA 解密指南,依据 IDA 反编译的结果, * 正确填充代码中的空缺处,运行后就可以获得 flag! * * @attention 请先移步 main 函数,阅读此题拆解! */
#define uint unsigned int
/** * @brief TEA 解密一个 64 位数据块 * * @param cipher 待解密数据(2×32 bit) * @param key 128 位密钥(4×32 bit) * @param delta 常量值 */void tea_decrypt(uint cipher[2], uint key[4]){ /** * @brief 解密是加密的逆过程。如果我们已知最终的密文, * 并可以通过某种方式恢复上一轮的状态, * 那么一直恢复到最初状态,就可以得到明文。 * 在此例中,加密的逻辑是这样的: * -> 先将 delta 减去 1640531527(或为加上 0x9E3779B9) * -> 更新 cipher[0] * -> 更新 cipher[1] * -> 重复以上操作,循环 32 次 * 由于更新某一个数据时,另外两个数据和密钥的值都是固定的, * 于是在解密时,我们只需要: * -> 反向更新 cipher[1] * -> 反向更新 cipher[0] * -> 将 delta 加上 1640531527(或为减去 0x9E3779B9) * -> 重复以上操作,循环 32 次 * * @attention 根据 IDA 反编译展示的逻辑,修改下面代码中填 0x0 的部分。 */ uint delta = -1640531527 * 32;
for (int i = 1; i <= 32; i++) { cipher[1] -= (cipher[0] + delta) ^ (16 * cipher[0] + key[2]) ^ ((cipher[0] >> 5) + key[3]); cipher[0] -= (cipher[1] + delta) ^ (16 * cipher[1] + *key) ^ ((cipher[1] >> 5) + key[1]); delta += 1640531527; }}
/** * @brief XTEA 解密一个 64 位数据块 * * @param cipher 待解密数据(2×32 bit) * @param key 128 位密钥(4×32 bit) * @param delta 常量值 */void xtea_decrypt(uint cipher[2], uint key[4]){ /** * @brief 这里的反编译可能会出现 *(_DWORD *)。 * 不用害怕,以 (4LL * (v4 & 3) + xtea_key_address) 为例, * 由于 uint 的存储空间为 4 字节,乘上几个 4 就代表偏移量是几。 * * @attention 根据 IDA 反编译的结果,修改下面代码中填 0x0 的部分。 */ uint delta = -1640531527 * 32;
for (int i = 1; i <= 32; i++) { cipher[1] -= (((cipher[0] >> 5) ^ (16 * cipher[0])) + cipher[0]) ^ (key[(delta >> 11) & 3] + delta); delta += 1640531527; cipher[0] -= (((cipher[1] >> 5) ^ (16 * cipher[1])) + cipher[1]) ^ (key[delta & 3] + delta); }}
int main(){ /** * @brief 你看懂 main 函数的逻辑了吗? * 本题分为两个加密部分: * 第一,tea_encrypt 函数对 flag 前 16 字节进行加密。 * 第二,xtea_encrypt 函数对 flag 后 16 字节进行加密。 * 密文分别存储在 tea_cipher 和 xtea_cipher 中。 * * @attention 让我们先来解密 tea_encrypt 部分! * 请双击 check_tea_part 函数,找到这部分的密文以及密钥。 */
/** * @brief 密文数组由 4 个 32 位无符号整数构成。 * * @attention 双击 tea_cipher,填充以下数据!我已经帮你填好一个了。 */ uint cipher1[4] = { 0xB3E7E33E, 0xB4114672, 0x8E088C0C, 0x14B2C329 }; /** * @brief 密钥数组同样由 4 个 32 位无符号整数构成。 * 双击 get_tea_key_address,再双击 tea_key,填充... * 等一下,我的 32 位整数呢?!实际上,呈现在你面前的 16 字节, * 是密钥数组在内存中原始的存储形式。按每四个字节划分, * 就可以得到 4 个密钥。那么,第一个密钥是 0x78563412 吗? * 并不是!x86-64 机器一般采用小端序存储。记住一点: * 低位字节存储在低地址,高位字节存储在高地址。因此, * 第一个密钥应该是 0x12345678。 * * @attention 完成剩下的填充! */ uint key1[4] = { 0x12345678, 0x87654321, 0x13572468, 0x24681357 }; /** * @brief 加密算法 TEA 要求加密密钥为 128 比特,密文块分组长度为 64 比特。 * 这里密文长度为 128 比特,因此要分为两个块分别加密。 * * @attention 请移步 tea_decrypt 函数,完成解密逻辑编写! */ tea_decrypt(cipher1, key1); tea_decrypt(cipher1 + 2, key1);
/** * @brief 祝贺你成功完成第一部分的解密!第二部分是 xtea 解密, * 整体思路和 tea 差不多,不过在加密流程中有些许出入。 * * @attention 填充对应密文。 */ uint cipher2[4] = { 0x60EC68AB, 0x940251CE, 0xB427534C, 0xDF435416 }; /** * @attention 填充对应密钥。注意:别忘记小端序! */ uint key2[4] = { 0xDEADBEEF, 0xCAFEBABE, 0x11223344, 0x55667788 }; /** * @attention 移步 xtea_decrypt,继续完成解密逻辑编写。 */ xtea_decrypt(cipher2, key2); xtea_decrypt(cipher2 + 2, key2); /** * @attention 补全所有部分后,运行程序。如果解密正确,就能看到输出的 flag 啦! */ printf("%.16s%.16s\n", (char*)cipher1, (char*)cipher2);
return 0;}总结
毕竟是week1,挺简单的,不过后面我有点想跑路pwn了,所以这几天进度很缓慢(主要是汇编又在赤石,又看不懂了…)
还有,艾斯比电分不给我补考,估计要度过一个很傻逼的大二大三了
Some information may be outdated